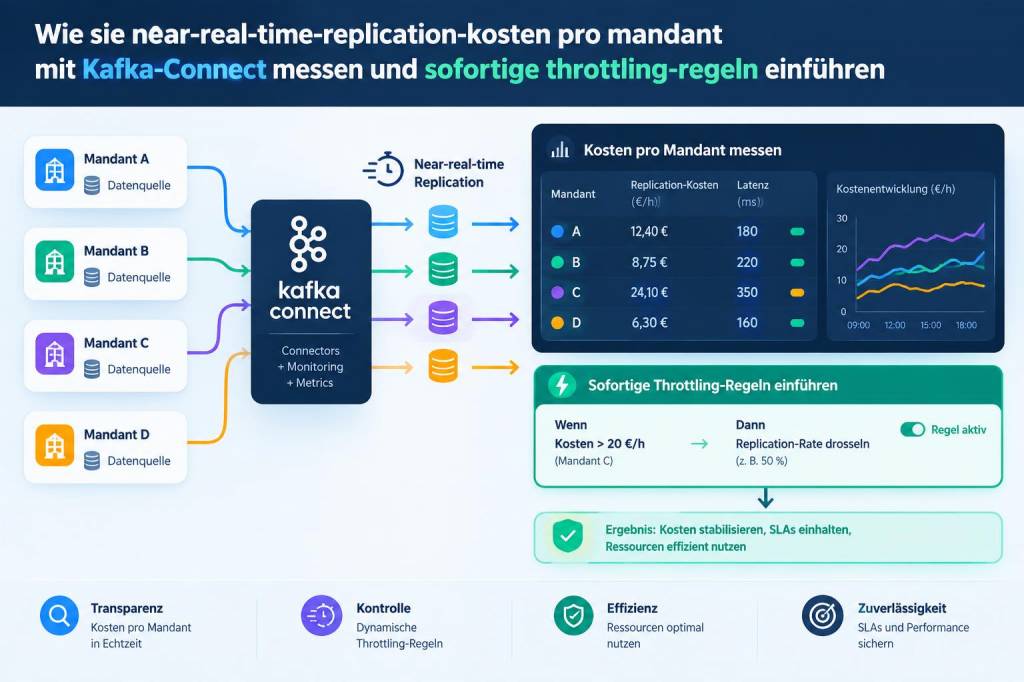
In vielen Integrationsprojekten, die ich begleite, steht die Frage im Raum: Wie messe ich die Kosten für near‑real‑time‑Replication pro Mandant und wie kann ich bei Bedarf sofort drosseln, bevor die Rechnung explodiert oder die Plattform leidet? In diesem Beitrag teile ich meine pragmatische Vorgehensweise mit Kafka Connect, inklusive konkreter Metriken, Implementierungstipps und Vorschlägen für sofort wirkende Throttling‑Regeln.
Warum per‑Mandant‑Kosten messen?
Technisch können wir viele Replikationen parallel fahren — wirtschaftlich ist das nicht immer sinnvoll. Ohne mandantenbezogene Kostenrechnung gerät man schnell in Situationen, in denen ein einzelner Kunde die Infrastruktur dominiert (durch hohe Änderungsraten, große Rows oder viele BLOBs). Eine differenzierte Messung erlaubt:
- nachvollziehbare Abrechnung oder Chargeback;
- rechtzeitiges Erkennen von „noisy neighbors“;
- Zielgerichtetes Throttling, das SLAs respektiert;
- Analyse von Optimierungspotenzial (z. B. Change‑Data‑Capture‑Filter, Kompression).
Grundprinzip: Metrik‑Erhebung pro Mandant
Um Kosten pro Mandant zu messen, braucht es drei Dinge: Identifizierbarkeit der Ereignisse/Datensätze, Metrik‑Collection auf Connector/Task‑Ebene und ein Bewertungsmodell (was kostet Byte, Message, CPU‑Zeit etc.).
1) Mandantenkennzeichnung
Wenn Daten mehrere Mandanten in einem Stream enthalten, müssen wir einen Mandanten‑Identifier mitführen:
- Bei Debezium oder anderen CDC‑Quellen: Konfigurieren, dass der Mandanten‑Key im Payload oder im Headers‑Feld landet.
- Bei Multi‑tenant‑Apps: Einen Single Message Transform (SMT) in Kafka Connect nutzen, um das Feld
tenantIdin den Record Header zu schreiben (z. B. mit dem RegexRouter/InsertField SMTransformation). - Wenn möglich: pro Mandant eigene Topics oder Topic‑Partition‑Schemata verwenden — das vereinfacht spätere Aggregationen.
2) Metrik‑Erfassung mit Kafka Connect & Observability‑Stack
Kafka Connect liefert zahlreiche Metriken via JMX (Tasks, Connector throughput, error counts). Praktisch habe ich folgende Pipeline etabliert:
- JMX Exporter (Prometheus JMX Exporter) auf Connect‑Worker deployen;
- Export der Connect‑Metriken plus custom metrics (z. B. RecordsInPerSecond, BytesOut, Task CPU / JVM Metrics);
- Prometheus als Zeitreihen‑DB, Grafana für Dashboards und Alerts.
Wichtig: Damit Metriken mandantenbezogen werden, kombiniere die Connect‑Metriken mit dem tenant‑Header aus den Topic‑Messages. Zwei gängige Verfahren:
- Wenn pro Mandant eigene Topics vorliegen, sind Prometheus‑Labeling und metric_relabel_configs ausreichend.
- Bei gemischten Topics: einen Stream‑Processor (ksqlDB, Kafka Streams) einsetzen, der pro eingehendem Record die Größe (Bytes) und Zählung pro tenant aggregiert und diese Aggregationen in ein Monitoring‑Topic schreibt. Ein kleiner Consumer liest dieses Topic und expose‑t die Aggregationen via Pushgateway oder direkt in Prometheus.
Welche Metriken nutze ich konkret?
In meiner Praxis haben sich folgende Metriken bewährt — später werden wir sie zu Kosten umrechnen:
| Metrik | Bedeutung |
| records_in_total (per tenant) | Anzahl Datensätze, die pro Zeiteinheit repliziert werden |
| bytes_in_total / bytes_out_total | übertragene Bytes — zentrale Größe für Bandbreitenkosten |
| connect_task_cpu_seconds_total | CPU‑Zeit der Connect‑Tasks (pro Connector/Worker) |
| jvm_memory_used_bytes | Hinweis auf Heap‑Druck durch bestimmte Mandanten |
| records_failed | Fehlerliste — kann Kosten durch Retries/Dead‑Letter verursachen |
Kostenmodell: Von Metrik zu CHF
Ein einfaches, praxistaugliches Modell besteht aus gewichteten Komponenten. Beispiel (vereinfachte Demonstration):
| Komponente | Rechnung |
| Bandbreite | Bytes übertragen * Preis pro GB (z. B. 0.10 CHF/GB intern) |
| Requests / Records | Record‑Count * cost_per_record (z. B. 0.00001 CHF) |
| CPU/Worker | prozentualer Anteil CPU * Worker‑Stunden * CHF/Stunde |
| Storage (bei zwischenspeicherung) | Retention Bytes * CHF/GB-Monat |
Ich habe gute Erfahrungen damit, die Kosten in Echtzeit als Zeitreihe (Prometheus) zu berechnen: Prometheus sammelt Bytes/tenants und ein kleiner Kalkulator (z. B. ein Prometheus‑Recording Rule oder ein Microservice) wandelt das in CHF/h um. So entsteht eine live‑sicht auf Kosten pro Mandant.
PromQL‑Beispiele (vereinfachte Beispiele)
Beispiel‑Query für Bytes pro tenant in den letzten 5 Minuten:
sum by (tenantId) (increase(connect_records_bytes_total[5m]))
Um das in CHF/h zu übersetzen, nutze ich eine Recording Rule, die das Ergebnis mit einem Preiskonstanten multipliziert.
Sofortige Throttling‑Regeln
Kurzfristiges Throttling muss wirksam, präzise und automatisierbar sein. Folgende Optionen verwende ich, je nach Setup:
- Connector/Task Pause & Resume: Kafka Connect REST API kann Tasks oder Connectoren pausieren. Ich setze im Alertmanager eine Webhook‑Action, die bei Überschreitungen (z. B. wenn ein Tenant > X CHF in 1h) den betreffenden Connector für diesen Mandanten pausiert oder in einen Gedrosselten Modus versetzt.
- Client‑Quotas auf Broker‑Ebene: Kafka unterstützt client quotas (Bytes in/out pro Client oder User). Über Kafka Admin API kann man dynamisch Quotas setzen. Vorteil: indirktes, brokerseitiges Drosseln.
- Per‑Tenant Throughput‑Limits via Stream Processor: Nutze Kafka Streams oder ksqlDB, um Events eines Tenants zu buffer‑ oder window‑rate‑limitieren und nur mit X Events/sec weiterzubefördern.
- SMT‑basierte Sampling: Eine SMT, die bei Überschreitung Sampling aktiviert (z. B. nur 1/10 Events für bestimmte tenantId weitergeben).
Praktisches Regelset (Beispiel)
So setze ich automatisierte Regeln in Projekten:
- Alarm wenn tenant_cost_hourly > 50 CHF → Benachrichtigung an Owner + 5‑min Verzögerung prüfen;
- Wenn tenant_cost_hourly > 200 CHF → automatischer Webhook: Connector pausieren + Ticket öffnen;
- Wenn tenant_bytes_5m > 2GB → broker client quota senken (set quota in Admin API), Connector in „reduced throughput“ switchen (SMT Sampling);
- On repeated offences (3x in 24h) → dauerhaftes Limit, Gespräch mit Kunde/Owner vereinbaren.
Implementationshinweise & Tools
Tools, die ich regelmäßig nutze:
- Debezium für CDC;
- Confluent Platform / Apache Kafka mit Connect;
- Prometheus + Grafana für Metrik‑Storage und Alerts;
- JMX Exporter für Connect‑Metriken;
- ksqlDB / Kafka Streams für per‑tenant Aggregationen;
- Alertmanager Webhooks und ein kleines Admin‑Service (Node/Python), das Quotas/Connect REST anspricht.
Tipp: Falls Sie Confluent Cloud nutzen, prüfen Sie die verfügbaren Quota‑APIs und Observability‑Integrationen; einige Schritte lassen sich dort einfacher umsetzen.
Fehlerquellen & Best Practices
Aus meiner Erfahrung sollten Sie auf folgende Punkte achten:
- Genauigkeit der tenant‑ID: Inkonsistente IDs führen zu verfälschten Kosten. Standardisieren Sie das Feld früh im Pipeline.
- Messintervall: Zu grobe Intervalle verwischen Peaks; zu feine führen zu hoher Last auf Monitoring. 1–5 Minuten sind oft ein guter Kompromiss.
- Kostenmodell regelmäßig validieren: Preise und Worker‑Kosten ändern sich — Periodisch (vierteljährlich) verifizieren.
- Notfall‑Bypass: Für Kunden mit SLA kann ein manuelles Override nötig sein — planen Sie diesen Prozess.
Wenn Sie möchten, kann ich Ihre aktuelle Connect‑Topologie kurz reviewen und eine konkrete Liste an Metriken und PromQL‑Rules zusammenstellen — oder ein kurzes Workshop‑Format vorschlagen, um per‑Tenant‑Metriken und Throttling in 2–3 Schritten produktiv zu machen.