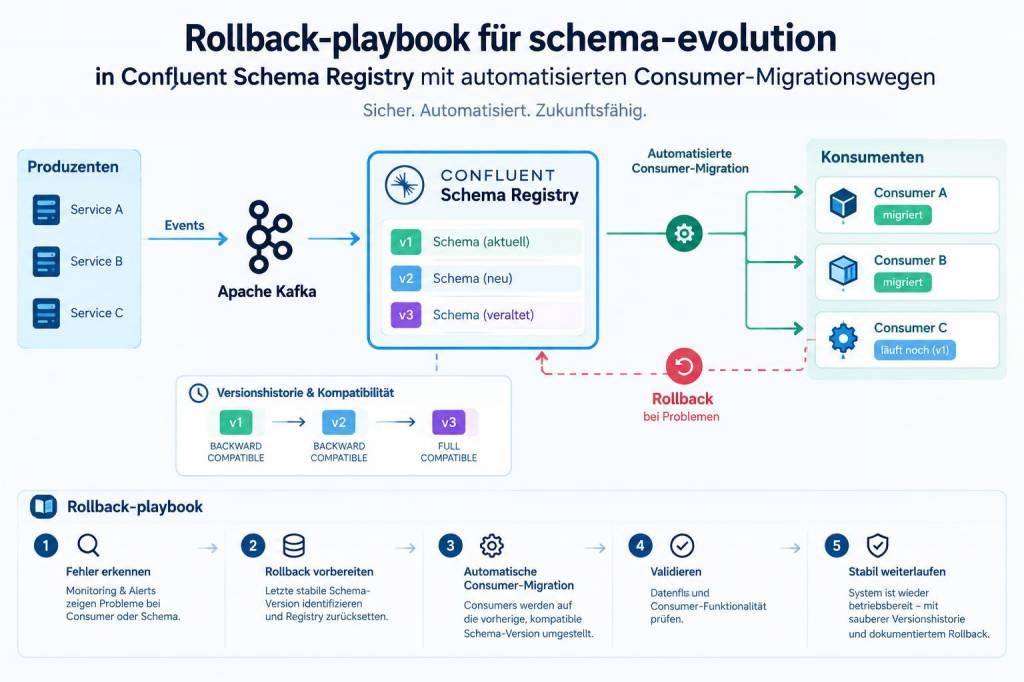
Schema‑Evolution in einer produktiven Kafka‑Landschaft ist eine der häufigeren Quellen für Herzrasen bei Integrationsprojekten. Bei Confluent Schema Registry gibt es mächtige Mechanismen zur Kompatibilitätsprüfung — aber wenn etwas schiefgeht, braucht man einen klaren Rollback‑Plan und automatisierte Pfade, um Consumer wieder in einen konsistenten Zustand zu bringen. In diesem Artikel teile ich mein Rollback‑Playbook für Schema‑Evolution mit Confluent Schema Registry und beschreibe praktische, getestete Maßnahmen zur automatisierten Consumer‑Migration und zurück.

Warum ein Rollback‑Playbook nötig ist

In Projekten, die ich begleitet habe, entstehen Probleme meist an den Schnittstellen zwischen Änderungen an Producer‑Schemas und der Fähigkeit vorhandener Consumer, neue Formate zu verarbeiten. Gründe sind:

  • Versteckte Inkompatibilitäten trotz positivem Kompatibilitätsstatus (z. B. komplexe Default‑Regeln).
  • Fehlende oder falsche Subject‑Namen/Schema‑Versionszuordnungen.
  • Consumer, die nahtloses Lesen neuer Felder nicht implementiert haben (z. B. strikte Deserialisierung).
  • Timing‑Probleme bei gleichzeitigen Deployment von Producer und Consumer.
  • Ein Playbook reduziert Entscheidungsdruck und minimiert Ausfallzeiten — insbesondere, wenn automatisierte Consumer‑Migrationspfade vorhanden sind.

    Grundprinzipien des Playbooks

  • Infrastruktur first: Bevor Änderungen kommen, habe ich Prüfungen in CI/CD, Tests in Staging (mit echten Schemas) und Canary‑Prozesse für Producer & Consumer implementiert.
  • Kompatibilität aktiv nutzen: Verwende Backward/Forward/Full‑Kompatibilität bewusst, nicht als Default‑Wert ohne Prüfung.
  • Automatisierte Migration: Consumer sollen über Feature Flags, Dual‑Read oder Transformations‑Layer schrittweise umgestellt werden können.
  • Observability: Schemapublishes, Deserialisierungsfehler und Consumer‑Lag müssen zentral sichtbar sein.
  • Vorbereitende Maßnahmen (Prävention)

    Bevor ich überhaupt ein Schema ändere, stelle ich folgende Punkte sicher:

  • Subject Naming Strategy dokumentiert (z. B. topic‑key, topic‑value oder record‑name) und in der Registry konsistent angewendet.
  • Kompatibilitätslevel pro Subject gesetzt (meist BACKWARD für Veränderungen, die alte Leser unterstützen sollen).
  • Consumer‑Tests, die Deserialisierungsfehler erkennen; diese laufen in CI mit echten Confluent‑Mocks oder lokalen Registries (z. B. Testcontainers).
  • Plan für Canary Releases: Producer in einer kleinen Partition/Topic‑Subset aktivieren und Consumer‑Metriken überwachen.
  • Standard‑Rollback‑Schritte

    Wenn ein neues Schema Probleme verursacht, arbeite ich sequenziell und möglichst reversibel:

  • 1. Stabilisieren: Producer sofort einfrieren oder auf vorherige Version zurücksetzen (Feature Flag oder Deployment Rollback). Ziel: keine weiteren inakkonsistenten Daten erzeugen.
  • 2. Validieren: Prüfen, welche Consumer Deserialisierungsfehler zeigen (Fehlerraten, Dead‑letter‑Queues, Logs). Identifiziere die betroffenen Versionskombinationen.
  • 3. Schema‑Triage: In der Registry die betroffene Subject‑Version analysieren. Ist die neue Version wirklich inkompatibel oder ist das Problem bei Consumer‑Code?
  • 4. Revert oder Patch: Wenn das Schema tatsächlich das Problem ist, kann ich:
  • a) Das funktionierende Schema erneut registrieren (wenn möglich als neue Version mit kompatiblem Flag),
  • b) oder das Schema patchen, sodass es kompatibel zu den bestehenden Consumer wird.
  • 5. Consumer‑Rollback oder Migration: Entscheiden, ob Consumer zurückgesetzt oder in einer Migration berücksichtigt werden müssen (siehe Abschnitt Automated Migration Paths).
  • 6. Monitoring & Clean‑up: Nach Stabilisierung beobachte ich Deserialisierungsfehler, Reproducibility und entferne temporäre Flags/Workarounds.
  • Automatisierte Consumer‑Migrationswege

    Automatisierung ist der Schlüssel, um menschliche Fehler zu reduzieren und Rollbacks schnell auszurollen. Ich favorisiere drei Muster, die sich in der Praxis bewährt haben:

    Dual‑Read / Fan‑in Adapter

    Consumer lesen zeitgleich aus zwei Deserializern: dem alten und dem neuen. Eine Middleware entscheidet, welches Ergebnis verwendet wird oder fasst differente Outputs zusammen. Vorteile:

  • Nahtloser Vergleich beider Implementierungen.
  • Kann automatisch Fehler erkennen und auf den alten Deserializer zurückfallen.
  • Implementierungstipps:

  • Setze Feature Flags, um Dual‑Read per Konfigurationswechsel zu aktivieren.
  • Nutze Side‑by‑Side Tests im Prod‑Traffic mit Sampling (z. B. 1% der Nachrichten dual lesen).
  • Schema‑Shimming / Transformations‑Layer (Kafka Streams, KSQL, Connector SMT)

    Ein Transformations‑Layer wandelt Nachrichten in das erwartete Format um, bevor sie den Consumer erreichen. Das kann mit Kafka Streams, KSQL oder SMTs in Connectern erfolgen.

  • Ideal, wenn Producer schnellere Releases benötigen, Consumer aber langsamer nachrüsten.
  • Kann automatisiert aktiviert/deaktiviert werden und ist gut beobachtbar.
  • Consumer‑Feature Flags & Safe Deserialization

    Wenn Consumer defensive Deserialisierung unterstützen (ignorieren unbekannter Felder, Default‑Werte), lassen sich Migrationen schrittweise durchführen. Feature Flags steuern das Verhalten (z. B. neue Feldnutzung an/aus).

    Praktische Befehle & Registry‑Hacks

    Ein paar häufig genutzte Aktionen in Confluent Umgebung:

    Schema abrufencurl -s -u user:pw https://schema-registry/api/subjects/{subject}/versions/{version}
    Kompatibilität prüfencurl -X POST https://schema-registry/compatibility/subjects/{subject}/versions/{version} -d '{ "schema": "..."}'
    Altes Schema erneut veröffentlichenRegistriere das alte Schema als neue Version oder setze den kompatibilitätsmode temporär strenger, um Inserts zu blockieren.

    Achtung: Direktes Löschen/Überschreiben alter Versionen ist normalerweise keine Option und riskant. Besser arbeiten mit neuen, kompatiblen Versionen oder Transformationen.

    Offsets, Backfills und Datenkonsistenz

    Ein häufiger Stolperstein: Rollback des Schemas ist nicht genug, wenn Consumer bereits fehlerhafte Zustände aufgebaut haben. Ich überprüfe:

  • Ob Consumer Offsets zurückgesetzt werden müssen (z. B. Seek to Beginning für betroffene Partitions) — vorsichtig, da das Reprocessing Effekte auf Side‑Effects hat.
  • Ob es Backfills braucht (Transformieren von Topic‑Daten in eine neue Topic mit korrigiertem Schema über Kafka Streams).
  • Ob Idempotenz und Exactly‑Once berücksichtigt sind; bei Replays brauchst du Mechanismen gegen doppelte Verarbeitung.
  • Monitoring und Alerts

    Ein Rollback ist nur so gut wie die Sicht, die du darauf hast. Ich tracke:

  • Schema‑Publishes und alle API‑Calls an die Registry.
  • Deserialisierungsfehler in Consumer‑Logs (z. B. Avro exceptions).
  • Consumer‑Lag, Error‑Rates und Processing‑Durations.
  • Alerts sind so konfiguriert, dass sie nicht nur Fehler melden, sondern auch die betroffenen Subject‑Namen und Consumer‑Gruppen auflisten.

    Beispiele aus der Praxis

    In einem Projekt bei einem Finanzdienstleister fügten wir ein optionales Feld zu einem Avro‑Record hinzu und setzten BACKWARD‑Kompatibilität. Trotzdem traten Fehler auf, weil ein Consumer eine strikte POJO‑Bindung nutzte. Unser Vorgehen:

  • Sofortiges Rollback des Producer‑Deployments (Feature Flag).
  • Schneller Patch: Transformation mittels Kafka Streams, die fehlende Felder injizierte, bis Consumer geupdated waren.
  • Parallel: Consumer‑Rollback in einer Canary‑Gruppe per Deployment‑Rollback getestet, dann stufenweise Upgrade mit Feature Flags.
  • Das gesamte Vorgehen war in einem Playbook dokumentiert und konnte in weniger als 30 Minuten einmalig ausgeführt werden — ein klarer Beweis für den Wert von Vorbereitung.

    Checkliste für dein Rollback‑Playbook

  • Subject‑Naming & Kompatibilität dokumentiert
  • Automatisierte Tests in CI für Producer & Consumer
  • Feature Flags für Producer & Consumer
  • Dual‑Read oder Transformations‑Layer als Notfallpfad
  • Monitoring für Deserialisierungsfehler
  • Playbook mit klaren Schritten: Stabilisieren, Validieren, Revert/Patch, Consumer‑Migration
  • Wenn du willst, kann ich dir eine konkrete Playbook‑Vorlage in JSON/YAML für deine CI/CD‑Pipelines erstellen — inklusive curl‑Skripten, Health‑Checks und Flag‑Konfigurationen für typische Plattformen (Confluent Cloud, self‑managed Registry, Kafka Connect). Schreib mir dazu die wichtigsten Details deiner Umgebung (Registry‑URL, Subject‑Naming, Typ der Serialisierung) — dann mache ich dir ein direkt anwendbares Paket.